Le champ de recherche est le clic le plus intentionnel du site. Une cliente qui tape « blouson cuir » sait ce qu’elle veut, et elle juge la marque sur ce qui s’affiche dans la seconde.
Depuis des années, ce champ reposait sur Algolia, en SaaS. Ça marchait. Mais le moteur, ses réglages et sa clé vivaient chez quelqu’un d’autre, et chaque ajustement de pertinence se faisait dans une console que notre code ne connaissait pas.
Cet été, on a construit notre propre recherche sur Meilisearch, hébergée dans notre cluster. Changer de moteur sur un site de mode sans mesurer, c’est jouer au casino avec le chiffre d’affaires : on a donc mis les deux moteurs face à face, en A/B test, sur les neuf storefronts.
Verdict après deux mois : égalité. C’était exactement le résultat qu’on espérait.
Pourquoi sortir d’Algolia
Algolia est un très bon produit. Le problème était la dépendance :
- la pertinence ne vivait pas dans notre code. Les règles de classement, les synonymes, la tolérance aux fautes se réglaient à la main dans une interface, sans revue, sans historique partagé avec le reste du projet ;
- le coût suit le trafic, et notre trafic de recherche ne fait que monter ;
- la recherche partait du navigateur avec une clé publique, directement vers un service externe ;
- et surtout, on voulait pouvoir brancher nos propres signaux sur le classement, ce qu’un moteur fermé rend compliqué.
On avait un atout : nos fiches produit existent déjà sous une forme aplatie, la même projection du catalogue que celle qui alimente Algolia. Un deuxième moteur pouvait recevoir exactement les mêmes documents, au champ près. La comparaison serait honnête.
D’abord, rendre le moteur remplaçable
Avant d’écrire une ligne de Meilisearch, on a passé quelques jours de juin à isoler Algolia derrière une interface. Le storefront ne parle plus d’Algolia, il parle d’un SearchProvider qui renvoie des produits normalisés.
export const useSearchProvider = (): ((arm: SearchProviderId) => SearchProvider) => {
  const algolia = useAlgoliaSearchProvider()
  const meilisearch = useMeilisearchSearchProvider()

  return arm => (arm === 'meilisearch' ? meilisearch : algolia)
}
Le détail qui compte : cette fonction choisit une implémentation, elle ne décide jamais du bras. C’est l’appelant qui tranche, une fois, et qui garde le même moteur pour toute une liste de résultats, page 1 et pages suivantes comprises. Un « charger plus » qui changerait de moteur en cours de route mélangerait deux classements.
Un moteur qui ne sait pas se répliquer
Meilisearch, dans sa version open source, est un moteur mono-écrivain : il ne sait ni former un cluster ni se répliquer. Pour un site qui vend dans neuf marchés, une seule instance, c’est une panne de recherche à chaque redémarrage de nœud.
On n’a pas cherché à contourner le moteur. On a mis la haute disponibilité dans l’architecture :
- deux instances totalement indépendantes, une par zone de disponibilité, chacune avec sa copie complète de tous les index ;
- l’indexeur fait la réplication : Magento écrit chaque changement deux fois, une fois par instance ;
- le consommateur bascule : le storefront interroge une instance primaire fixe et se rabat sur l’autre en cas d’échec.
Chaque instance est volontairement banale : un Meilisearch mono-nœud, sans rien autour. Tout le comportement distribué tient dans la boucle de l’indexeur et la bascule du proxy.
Trois règles rendent l’ensemble robuste :
- Fail-open par instance. Si une instance ne répond pas, l’indexeur l’ignore, le note dans les logs et continue avec l’autre. Une instance morte ne bloque ni sa jumelle ni la file d’indexation partagée avec Algolia : un index de recherche un peu en retard se rattrape, une file d’indexation gelée bloque tout le catalogue.
- Les pods sont jetables. Pas de volume persistant : l’état vit sur disque local, et un sidecar envoie un snapshot sur S3 toutes les six heures. Un pod qui redémarre sur un autre nœud recharge le dernier snapshot en quelques secondes. La clé S3 contient la version du moteur : une montée de version ne trouve aucun snapshot compatible, démarre vide et se fait remplir par une réindexation, plutôt que d’importer un fichier qu’elle ne sait pas lire.
- Une réindexation complète chaque nuit, sans interruption de service : on construit un index temporaire, on le remplit, on l’échange atomiquement avec l’index en ligne. Une instance qui aurait raté des mises à jour converge en moins de 24 heures. Et si la reconstruction produit zéro document, l’échange n’a pas lieu : on garde l’index en ligne plutôt que de servir un catalogue vide.
Le chemin d’une requête
Le navigateur ne parle jamais à Meilisearch. Le moteur n’est exposé qu’à l’intérieur du cluster, et une seule route du storefront sait qu’il existe : un proxy Nitro qui porte les clés de recherche côté serveur.
Le proxy fait peu de choses, mais il les fait toutes :
- il valide la requête avec Zod : requête de 200 caractères au plus, pagination bornée, magasin pris dans une liste dérivée de la configuration des pays, pour qu’aucun nom d’index ne puisse être forgé côté client ;
- il construit le filtre côté serveur. Le client choisit un mode dans une énumération fermée (
serpouarchive), jamais une expression de filtre : la visibilité des produits ne se négocie pas depuis le navigateur ; - il interroge une primaire fixe, pas un répartiteur de charge. Les deux instances sont des copies cohérentes à terme, à quelques secondes près pendant l’indexation : une cliente qui oscillerait entre les deux verrait ses résultats bouger d’une page à l’autre ;
- il bascule sur l’instance B si la A échoue, avec un disjoncteur (trois échecs consécutifs, trente secondes de pause) et deux budgets de temps, deux secondes par essai et sept au total. Le total reste sous le délai de huit secondes du client, pour que le serveur épuise sa bascule avant que le navigateur abandonne.
Si les deux instances tombent, le proxy renvoie une 502 générique, et le provider côté client se rabat sur Algolia. Cette requête porte alors un drapeau fallback, et la mesure l’écarte : une panne ne doit pas pouvoir fausser l’expérience.
La pertinence, réglée dans le code
Le premier gain de Meilisearch n’est pas le moteur, c’est que toute la pertinence devient du code relu. Les réglages d’index vivent dans le module Magento, un fichier de base et une surcharge par magasin, éditables dans le back-office et poussés au moteur sans réindexation complète.
L’ordre de classement est un sandwich assumé :
"rankingRules": [
  "stock.is_in_stock:desc",
  "words",
  "typo",
  "exactness",
  "attributeRank",
  "ordered_qty_store_30d:desc",
  "wordPosition",
  "proximity"
]
Le stock d’abord : un produit indisponible ne passe jamais devant un produit qu’on peut acheter. Ensuite la pertinence textuelle. Puis, à pertinence égale, les ventes des trente derniers jours dans le magasin concerné : ce qui se vend à Madrid n’est pas ce qui se vend à Londres.
La tolérance aux fautes est désactivée sur les attributs où elle fait plus de mal que de bien (composition, catégories, libellés spéciaux). Les synonymes d’Algolia ont été migrés, complétés par des flexions générées à partir du catalogue.
Reste le cas qui fait la différence en pratique : la requête trop précise. Le proxy exige d’abord tous les mots, puis relâche seulement si rien ne sort :
let response = await search('all')
let degradation: SearchDegradation = 'strict'
if ((response.estimatedTotalHits ?? 0) === 0) {
  response = await search('last', await resolveWordDropQuery())
  degradation = 'word-drop'
}
if ((response.estimatedTotalHits ?? 0) === 0 && lastWord !== trimmedQuery) {
  response = await search('last', lastWord)
  degradation = 'last-word'
}
Le relâchement retire les mots en partant de la fin, là où le français place le qualificatif (« sac rock noir »). L’anglais fait l’inverse : dans « burgundy bag », le nom est à la fin. Sur les magasins anglophones concernés, on inverse donc l’ordre des mots avant de relâcher, pour que le nom survive. Ce réglage est par magasin, comme le reste.
Et tout ce qui n’avait pas besoin d’un moteur
La migration a aussi servi à se demander ce qui méritait vraiment un moteur de recherche. La recherche dans la FAQ, par exemple, portait sur quelques dizaines de réponses. On l’a remplacée par 80 lignes de TypeScript : normalisation des accents, distance de Damerau-Levenshtein (une inversion de deux lettres compte pour une faute, comme dans Algolia), mêmes seuils de tolérance. Plus d’appel réseau, plus d’index à maintenir.
La recherche dans les archives produit est devenue un simple mode du proxy, et l’application de vente utilisée en boutique a suivi sur les mêmes index.
Mesurer sans se mentir
Le mode de recherche se règle par magasin, dans le back-office Magento : algolia, meilisearch ou ab. Il est poussé en direct au storefront, sans déploiement (on détaille le mécanisme dans notre article sur le feature flipping par marché). On a ouvert le test par vagues : les États-Unis le 22 juillet, l’Allemagne et la Belgique les 27 et 28, cinq autres marchés le 3 août, la France le 1er septembre.
En mode ab, l’affectation se fait sur l’identifiant du cookie _ga : pair pour Algolia, impair pour Meilisearch, figé pour toute la visite. Deux règles qu’on a apprises en chemin :
- le rendu serveur n’affecte jamais. Un bras choisi pendant le SSR finirait dans le HTML mis en cache par le CDN, et serait servi à tout le monde. La toute première recherche d’un nouveau visiteur, avant que le cookie existe, part donc sur le moteur par défaut et sort de la mesure ;
- on étiquette le moteur réellement affiché, pas celui qu’on croyait avoir choisi.
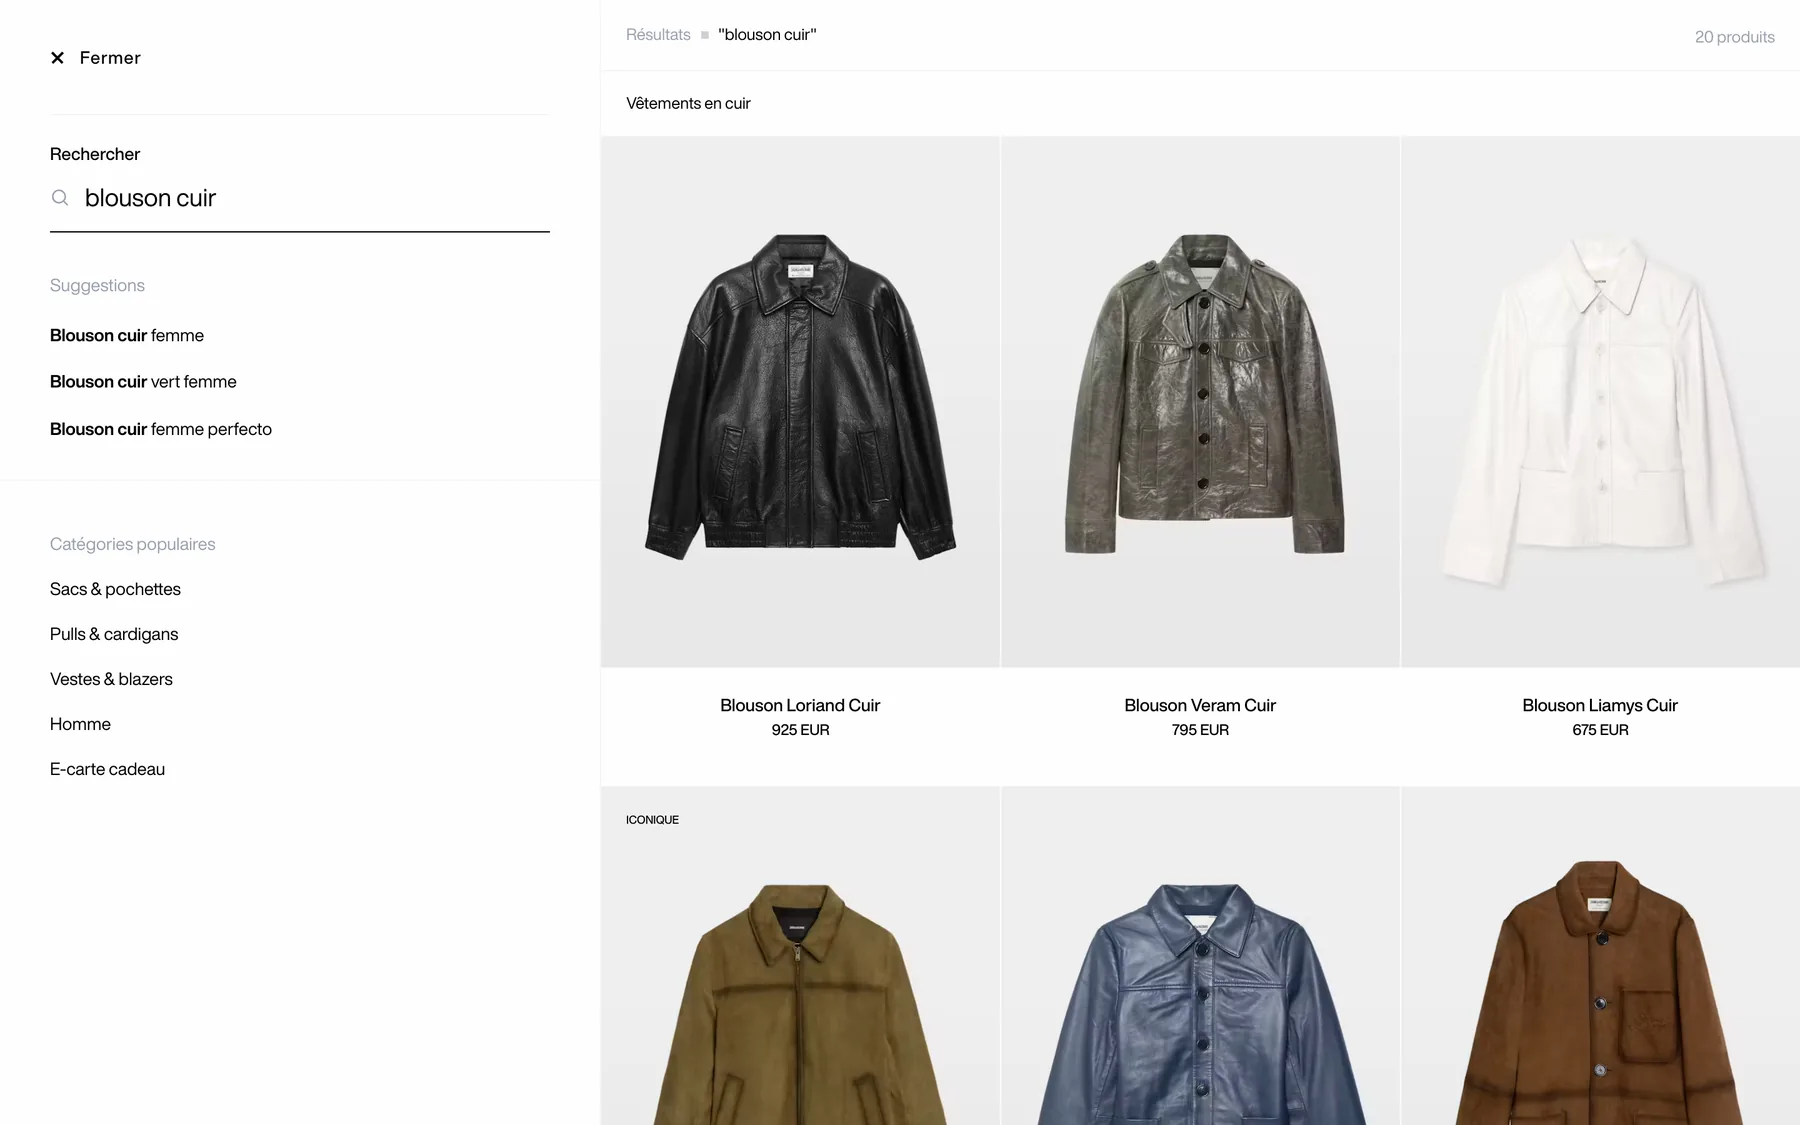
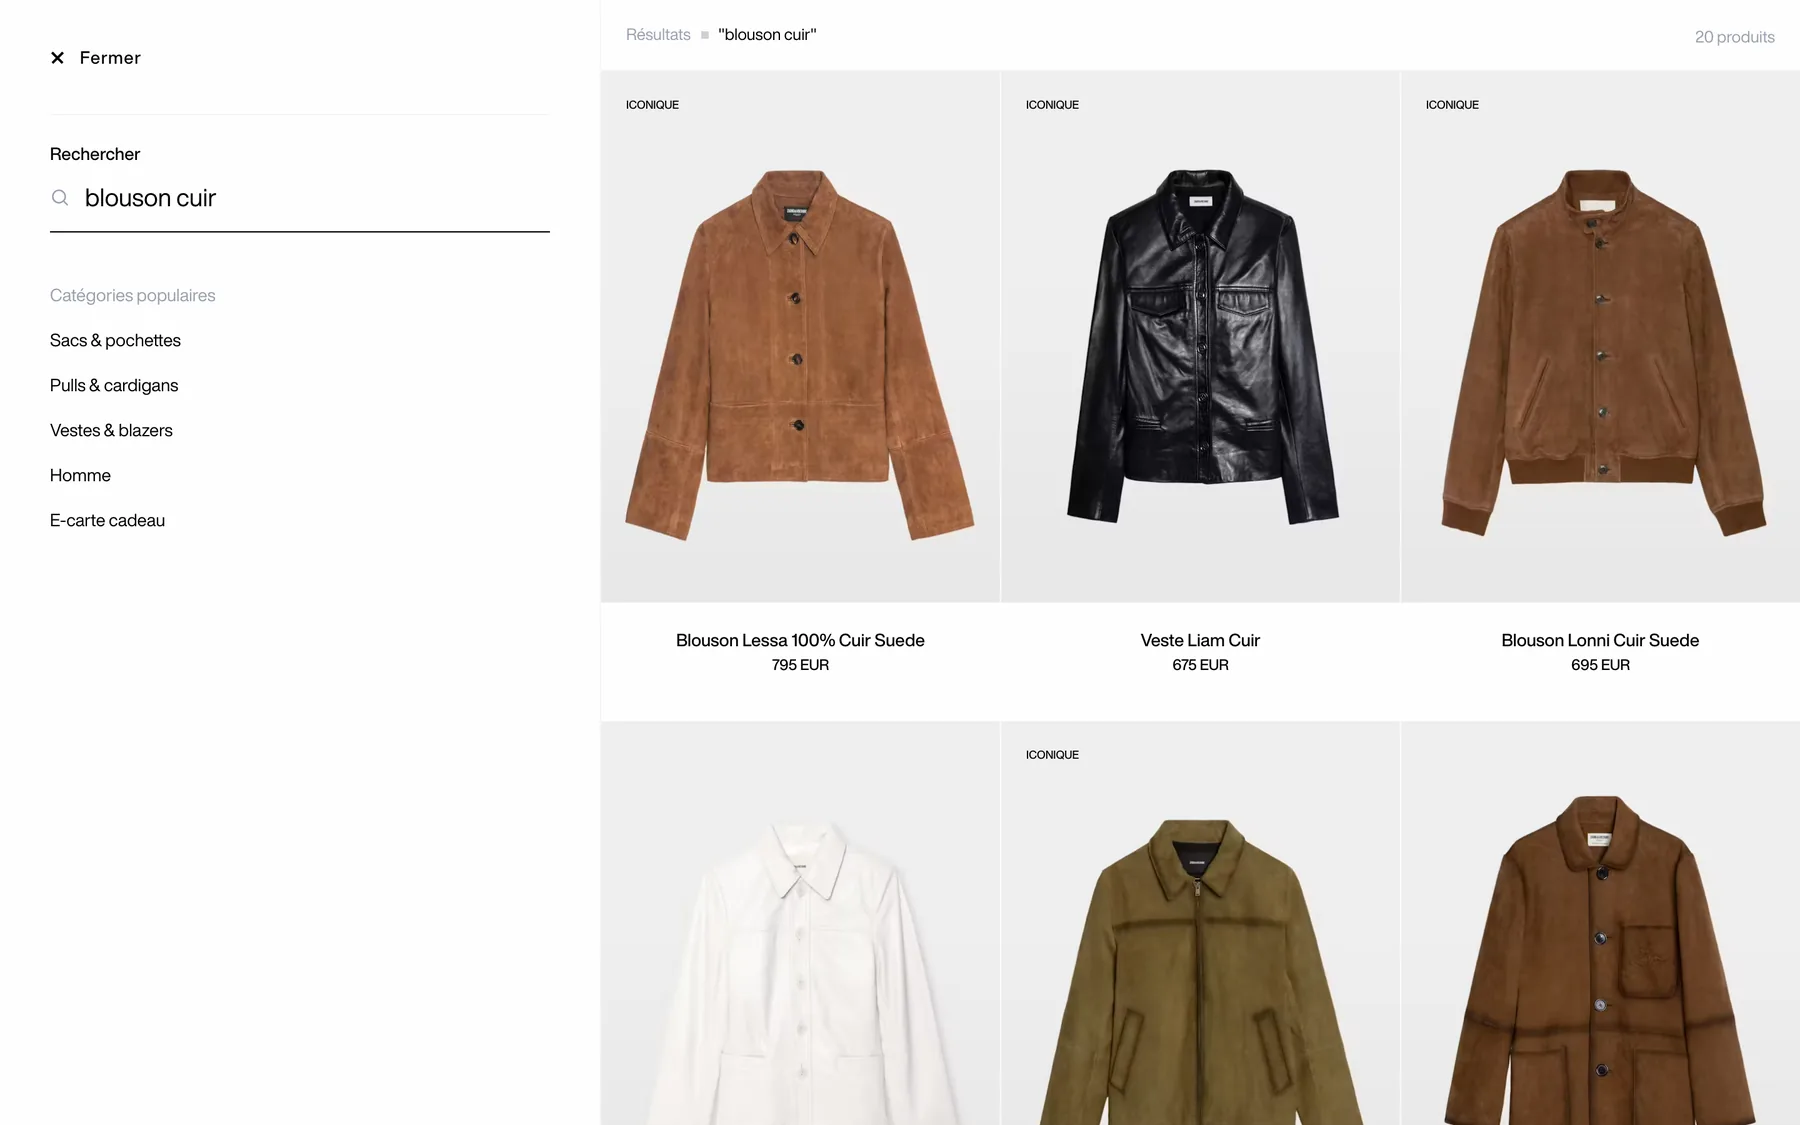
Le plus dur a été de lire le test. Sur les marchés européens, seuls les visiteurs qui acceptent les cookies de mesure ont un _ga, donc seuls eux sont testés : la conclusion porte sur cette population. Un visiteur peut aussi apparaître dans les deux bras (changement d’appareil, cookie effacé) : on le compte dans les deux, au numérateur comme au dénominateur, plutôt que de le rattacher au bras où il a le plus cherché, qui serait mécaniquement celui qui échoue le plus.
Et on a dû verrouiller les définitions. Nos premiers rapports, faits à la main d’une semaine sur l’autre, ne retiraient pas le trafic de repli et comptaient les visiteurs des deux bras de façon asymétrique. Ils annonçaient une avance de Meilisearch de plus de 30 % en Europe. Recalculée avec des définitions figées, l’avance de cette même semaine était de 16 %.
Les résultats
Données arrêtées au 27 septembre 2026, chaque marché sur sa propre fenêtre depuis son lancement :
| Europe hors France (7 marchés) | États-Unis | |
|---|---|---|
| Fenêtre | 55 à 62 jours | 67 jours |
| Répartition des chercheurs | 50 / 50 | 50 / 50 |
| Acheteurs par bras | environ 1 300 | environ 2 000 |
| Conversion, écart relatif Meilisearch / Algolia | +1,9 % (non significatif) | −1,5 % (non significatif) |
| Ajout au panier | identique (11,0 % des deux côtés) | identique à 0,1 point près |
| Chiffre d’affaires par chercheur, écart plausible (IC 95 %) | −8 % à +14 % | −11 % à +8 % |
Aucun marché, pris isolément, ne montre d’écart significatif de conversion. La France, entrée la dernière, se lit à part sur 26 jours : écart en faveur d’Algolia, non significatif.
Le graphique le plus instructif est celui de la trajectoire :
À la mi-août, l’Europe donnait Meilisearch gagnant de 16 %, avec un écart significatif. Le même jour, les États-Unis donnaient Algolia gagnant de 11 %, significatif lui aussi. Si on avait arrêté le test ce jour-là, on aurait tiré deux conclusions opposées, chacune avec un intervalle de confiance pour la défendre. Six semaines plus tard, les deux courbes se sont rejointes autour de zéro.
La pertinence, tranche par tranche
Le taux de recherches sans résultat racontait d’abord une belle histoire : en Europe, 9,5 % côté Meilisearch contre 18,2 % côté Algolia. Découpé par nombre de mots, il en raconte une autre.
| Requêtes (Europe, 17 au 27/09) | Algolia | Meilisearch |
|---|---|---|
| 1 mot | 11,9 % | 13,0 % (écart significatif) |
| 2 mots | 20,9 % | 2,4 % |
| 3 mots et plus | 34,2 % | 3,1 % |
Sur les requêtes longues, Meilisearch ne renvoie presque jamais zéro résultat parce qu’il relâche, alors que nos index Algolia européens, eux, ne relâchaient pas. Sur les requêtes d’un mot, la seule tranche où aucun des deux ne relâche, Algolia échoue un peu moins souvent. Aux États-Unis, où les deux moteurs relâchent, Algolia fait mieux sur toutes les tranches. Le taux global mesurait donc la différence de stratégie de relâchement, pas la pertinence. Notre chantier est là : les requêtes d’un seul mot.
Et maintenant, Personalize
Depuis le 29 septembre, la première page de résultats du bras Meilisearch est re-triée par Amazon Personalize, et dès le lendemain ce re-tri s’est fait côté serveur, avant que la page ne parte : le rendu n’attend le re-tri que 250 ms au plus, faute de quoi l’ordre du moteur est servi tel quel. Le même jour, la grille des catégories est passée en A/B entre Personalize et Nosto, sur la même affectation. À partir de cette date, le test compare donc le couple « Meilisearch + Personalize » à « Algolia + Nosto », et non plus deux moteurs seuls. Les chiffres ci-dessus s’arrêtent volontairement au 27 septembre : ils mesurent le moteur, rien d’autre. On raconte la suite dans notre article sur Personalize.
Ce qu’on a appris
- Une égalité, c’est une victoire. Le test devait prouver qu’on pouvait reprendre la main sur la recherche sans abîmer le chiffre d’affaires. Il exclut un écart commercial au-delà d’une dizaine de pour cent, dans un sens comme dans l’autre. La suite devient une décision d’architecture et de maîtrise, plus un pari.
- Ne jamais lire un A/B test trop tôt. Les deux avances significatives de la mi-août ont disparu. Une série de résultats non significatifs ne prouve pas l’égalité, mais une avance significative précoce ne prouve pas grand-chose non plus.
- Figer les définitions avant de publier un chiffre. Deux lectures défendables du même texte donnaient des écarts du même ordre que celui qu’on cherchait à mesurer.
- La haute disponibilité peut vivre dans l’architecture. Deux instances banales, un indexeur qui écrit deux fois, un proxy qui bascule : rien d’exotique.
- Rendre remplaçable avant de remplacer. L’interface
SearchProvidera coûté quelques jours en juin. Sans elle, l’A/B test aurait été un fork du storefront.
Le champ de recherche a l’air d’un détail. Le changer proprement a demandé une architecture, un protocole de mesure et de l’humilité devant les chiffres.